
Las universidades de investigación que se dedican a la inteligencia artificial (IA) y a la computación de alto rendimiento (HPC) enfrentan retos significativos debido a la complejidad de su infraestructura. Estos desafíos incluyen largos ciclos de adquisición de GPU, límites rígidos para la escalabilidad y complicados requisitos de mantenimiento, que dificultan el trabajo ágil de los investigadores en áreas clave como el procesamiento de lenguaje natural y la visión por computadora.
Para abordar estos problemas, Amazon ha introducido SageMaker HyperPod, una solución diseñada para aliviar la carga operativa en la construcción de modelos de IA. Este sistema permite una rápida escalabilidad en actividades como el entrenamiento, la optimización y la inferencia de modelos, apoyándose en un clúster que puede incluir cientos o miles de aceleradores de IA, como las GPU de NVIDIA H100 o A100.
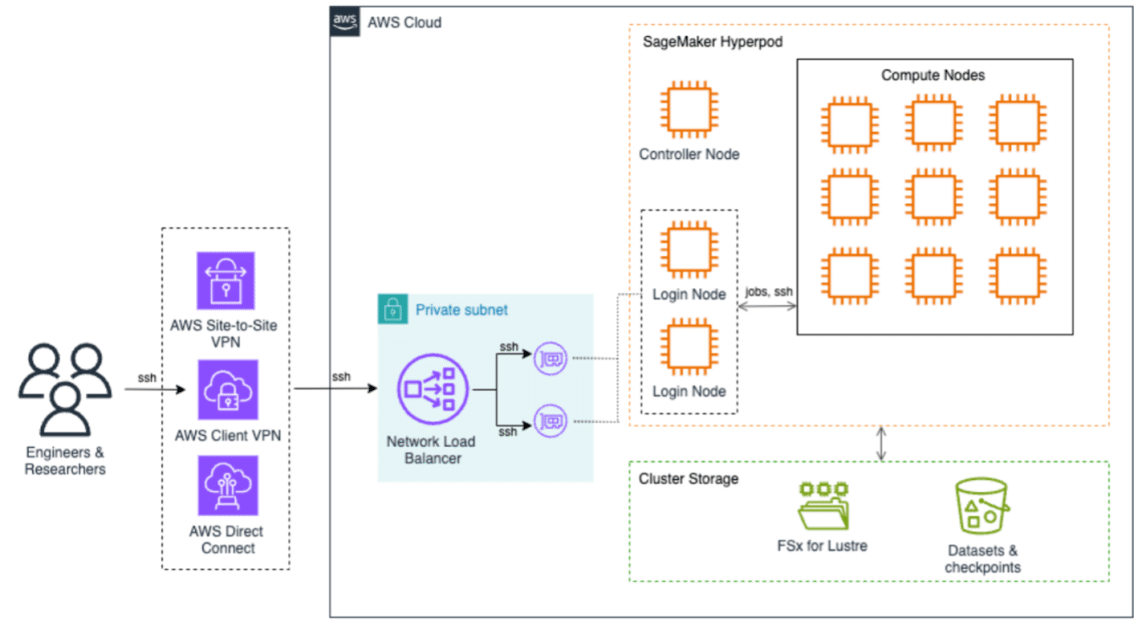
Recientemente, una universidad de investigación implementó este sistema con el fin de acelerar su trabajo en IA. Utilizando particiones dinámicas de SLURM y una gestión precisa de los recursos de GPU, los investigadores pudieron llevar a cabo su trabajo sin los contratiempos que acompañan a las infraestructuras tradicionales. Esta arquitectura no solo mejora el acceso a las herramientas necesarias, sino que también facilita el seguimiento de los costos computacionales y el balanceo de carga entre nodos de acceso.
La infraestructura de SageMaker HyperPod se gestiona completamente a través de AWS, lo que minimiza el esfuerzo operativo y maximiza la seguridad y el rendimiento. Los usuarios acceden a esta plataforma mediante opciones de conexión seguras que optimizan el tráfico y mejoran la interacción con el clúster.
En cuanto a la infraestructura de almacenamiento, esta se basa en dos componentes fundamentales: Amazon FSx para Lustre y Amazon S3. El primero proporciona un sistema de archivos de alto rendimiento, mientras que el segundo se encarga del almacenamiento seguro de conjuntos de datos y puntos de control, facilitando el acceso a la información necesaria para el entrenamiento de modelos.
La implementación de SageMaker HyperPod se realizó en varias fases, comenzando por la configuración de la infraestructura de AWS y luego personalizando la configuración del clúster SLURM para ajustarse a las necesidades del departamento de investigación. Esto incluyó la habilitación de la configuración de recursos genéricos (GRES), que optimiza el acceso a las GPUs al permitir que múltiples usuarios las utilicen simultáneamente sin conflictos.
Para garantizar la eficiencia y el control de costos, cada recurso del SageMaker HyperPod recibió un identificador único, lo que permite un seguimiento mensual del gasto a través de herramientas como AWS Budgets y AWS Cost Explorer. Además, un sistema de balanceo de carga para los nodos de acceso fue implementado, asegurando un acceso fluido a los recursos para varios usuarios en paralelo.
Finalmente, se integró un sistema de Active Directory para brindar un acceso seguro a los investigadores, asegurando un control unificado sobre las identidades y privilegios de los usuarios. Gracias a estas implementaciones, el uso de SageMaker HyperPod promete transformar la computación en el ámbito académico, permitiendo a las instituciones acelerar la innovación en IA y concentrarse en sus metas científicas, en lugar de lidiar con la complejidad de las infraestructuras tradicionales.


