

La extracción de datos estructurados de documentos como facturas, recibos y formularios sigue siendo un desafío considerable para muchas organizaciones. La diversidad en formatos, diseños y lenguajes complica la estandarización, mientras que los métodos manuales resultan ser lentos y propensos a errores. Las tecnologías tradicionales de reconocimiento óptico de caracteres (OCR) y los sistemas basados en reglas suelen ser insuficientes para abordar esta complejidad. Un claro ejemplo es el caso de un banco regional que necesita procesar miles de documentos, como solicitudes de préstamo y declaraciones de impuestos, donde los métodos manuales generan cuellos de botella y aumentan el riesgo de errores.
El procesamiento inteligente de documentos (IDP) se presenta como una solución a estos inconvenientes empleando inteligencia artificial (IA) para clasificar documentos, extraer información pertinente y validar los datos obtenidos, facilitando así su uso en diferentes procesos empresariales. Su principal objetivo es convertir documentos no estructurados o semi-estructurados en formatos utilizables y estructurados, como JSON, que permiten la inclusión de campos, tablas y otra información relevante.
Un avance significativo en este ámbito son los modelos de lenguaje visual (VLM), que combinan grandes modelos de lenguaje (LLM) con codificadores de imágenes especializados. Estos modelos ofrecen capacidades de IA multimodal que posibilitan tanto el razonamiento textual como la interpretación visual, lo que los diferencia de las herramientas tradicionales de procesamiento de documentos. Los VLM analizan los documentos de forma integral, permitiendo extraer significado con una precisión y comprensión contextual sin precedentes.
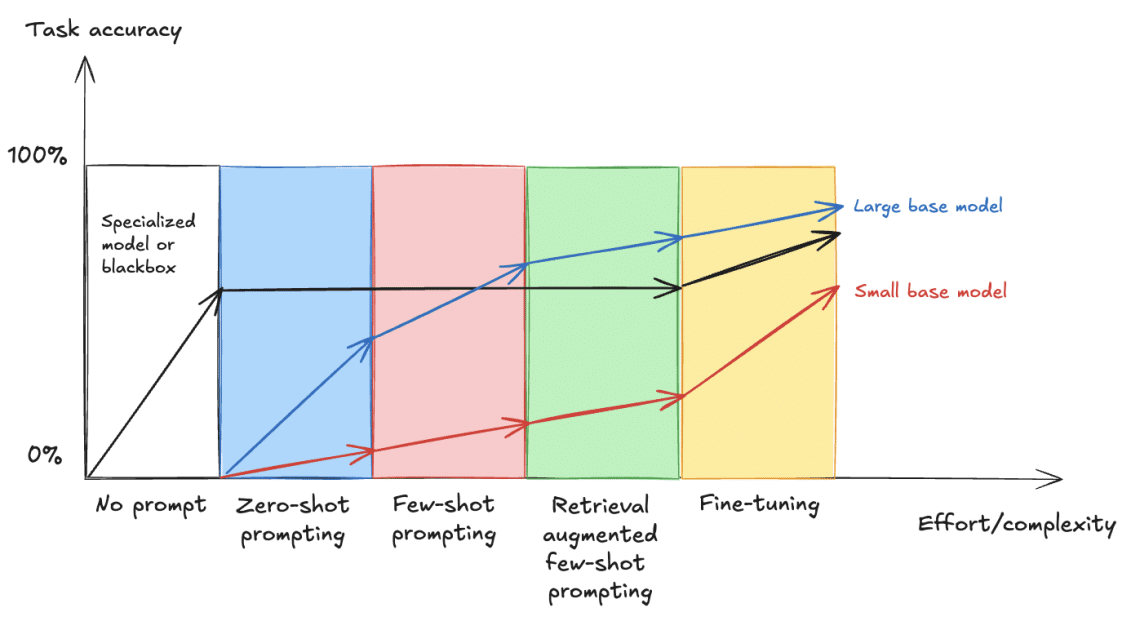
Sin embargo, la adopción de estas tecnologías y su implementación puede ser compleja. Dentro del IDP se presentan diferentes enfoques, incluyendo técnicas de ajuste fino que se consideran una solución escalable. Este proceso se realiza mediante un marco conocido como Swift, que facilita el ajuste fino de modelos de lenguaje visual para convertir documentos en formatos JSON.
La preparación de datos es igualmente esencial. Para el ajuste fino, es recomendable utilizar conjuntos de datos bien estructurados que contengan ejemplos anotados, lo que permite a los modelos aprender patrones específicos relacionados con el tipo de documentos a procesar.
Finalmente, tras ajustar un modelo, es fundamental evaluar su rendimiento. Indicadores como la tasa de error de caracteres y el índice de coincidencia exacta son cruciales para entender la calidad de los datos extraídos y asegurarse de que se cumplen los estándares exigidos por las empresas.
Las oportunidades para optimizar y expandir esta tecnología son vastas, ofreciendo a las organizaciones la posibilidad de implementar soluciones automatizadas en el procesamiento de documentos y generar información estructurada que puede mejorar significativamente su eficiencia operativa.


