
Los modelos de lenguaje de gran tamaño (LLMs) han avanzado a pasos agigantados, convirtiéndose en elementos imprescindibles en diversas aplicaciones, desde la inteligencia conversacional hasta tareas complejas de razonamiento. No obstante, la creciente magnitud y capacidad de estos modelos dificultan una evaluación precisa de su rendimiento. Las métricas de evaluación tradicionales, como la perplejidad y los puntajes BLEU, a menudo no reflejan las sutilezas de las interacciones en contextos reales, lo que hace que la creación de marcos de evaluación alineados con criterios humanos sea esencial. Comprender cómo se evalúan los LLMs es crucial para lograr despliegues más confiables y comparaciones equitativas entre diferentes modelos.
En este panorama, se han explorado métodos de evaluación automatizados que utilizan LLMs como evaluadores. Esta estrategia consiste en aplicar un modelo más avanzado para clasificar las respuestas generadas por otros LLMs, utilizando criterios específicos como la corrección, coherencia, utilidad o profundidad del razonamiento. Este enfoque se ha vuelto popular gracias a su escalabilidad, consistencia, rapidez en la iteración y eficiencia en costos, en comparación con la evaluación exclusivamente humana. El análisis reciente abarca diversos escenarios de evaluación que involucran LLMs como jueces, incluyendo comparaciones en pares y la asignación de puntajes a respuestas individuales.
Para ofrecer resultados concretos, se han utilizado MT-Bench y Arena-Hard, marcos de evaluación ampliamente reconocidos. MT-Bench proporciona un enfoque estructurado y multivuelta, ideal para interacciones tipo chatbot, mientras que Arena-Hard se centra en clasificar LLMs a partir de confrontaciones directas de respuestas en tareas desafiantes. Ambos marcos buscan equilibrar la evaluación automatizada con la humana, asegurando que los modelos no se midan solo con puntos de referencia sintéticos, sino también en situaciones prácticas.
El estudio examina todos los modelos de la familia Amazon Nova, que incluye a Amazon Nova Premier, la incorporación más reciente a la serie presentada en el evento AWS re:Invent de diciembre de 2024. Estos modelos están diseñados para ofrecer inteligencia de vanguardia, destacándose por su costo-efectividad en sus respectivas categorías. La familia Nova abarca diferentes niveles, desde Amazon Nova Micro, optimizado para implementaciones en el borde, hasta Amazon Nova Premier, que se especializa en tareas más complejas.
Además, gracias a la destilación de modelos en Amazon Bedrock, los clientes pueden transferir capacidades de inteligencia del modelo Nova Premier a versiones más rápidas y económicas, como Nova Pro o Nova Lite, adaptadas a dominios específicos. Este proceso está disponible a través de la consola de Amazon Bedrock y APIs como Converse e Invoke.
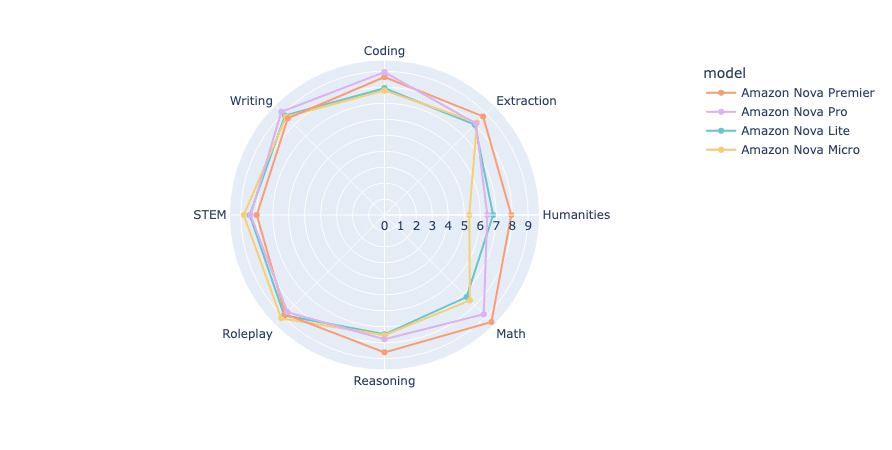
La evaluación realizada con MT-Bench y Arena-Hard ha revelado una clara jerarquía de rendimiento dentro de los modelos Amazon Nova. En términos de puntaje mediano, Amazon Nova Premier se destacó, seguido de Nova Pro, mientras que Nova Lite y Nova Micro presentaron resultados notables. Un análisis adicional de eficacia de respuesta mostró que, pese a ser el modelo más robusto, Nova Premier exhibió una eficiencia de tokens sobresaliente al generar respuestas más concisas y menos intensivas en recursos.
Por su parte, Arena-Hard-Auto aplica un conjunto de 500 indicaciones desafiantes para evaluar diversos LLM mediante comparaciones en pares, utilizando un modelo robusto que calcula el rendimiento de acuerdo con múltiples categorías de preferencias, permitiendo un análisis más profundo de las capacidades de cada modelo.
El estudio concluye que los modelos Amazon Nova ofrecen un rendimiento sólido en una variedad de tareas, a la vez que mantienen costos operativos más bajos. Esto los posiciona como una opción competitiva para empresas que buscan optimizar eficiencia sin sacrificar calidad, enfatizando la relevancia de las metodologías de evaluación en la selección y despliegue de modelos en aplicaciones del mundo real.


