

En el ámbito del análisis de datos, la integración de tecnologías de inteligencia artificial se vuelve cada vez más crucial, especialmente con plataformas como Amazon OpenSearch. Esta herramienta no solo permite realizar búsquedas en extensos volúmenes de datos, sino que también aborda la creciente necesidad de enriquecer la información antes de su indexación. Por ejemplo, cuando se procesan archivos de registro con direcciones IP, se hace esencial obtener la ubicación geográfica correspondiente; en otros casos, como en el análisis de comentarios de clientes, identificar el idioma de los textos resulta fundamental.
Las canalizaciones de ingestión tradicionales, que dependen de procesos externos para enriquecer los datos, pueden complicar la eficiencia del sistema y poner en riesgo su funcionamiento. Para simplificar este proceso, OpenSearch ha introducido diversos conectores de aprendizaje automático de terceros que facilitan el enriquecimiento de datos.
Uno de los conectores más destacados es Amazon Comprehend, que permite detectar el idioma de los documentos mediante la implementación de la API LangDetect. Otro conector relevante es Amazon Bedrock, que habilita el uso del modelo de embeddings de texto Amazon Titan Text Embeddings v2, lo que facilita la búsqueda semántica en documentos redactados en múltiples idiomas.
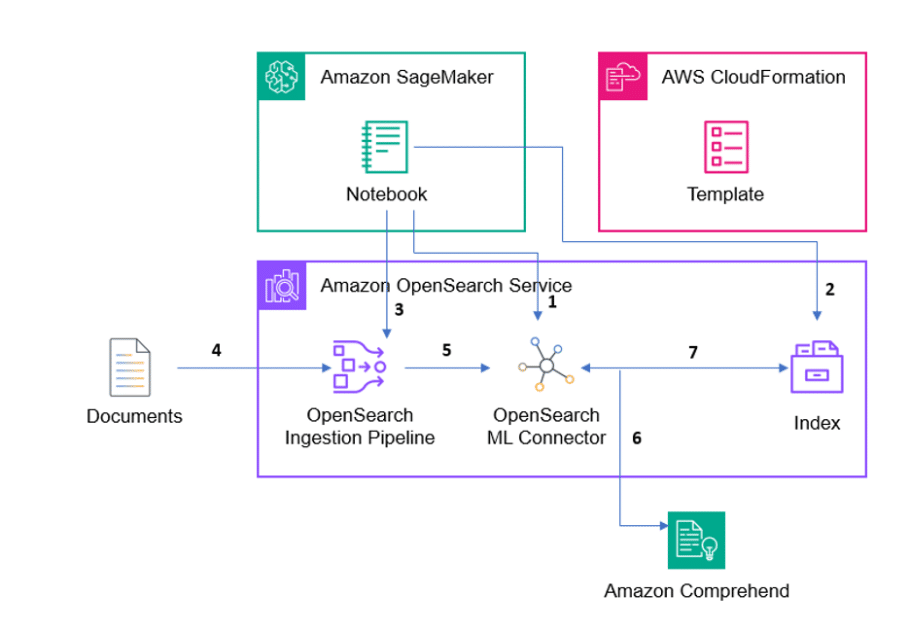
Para ilustrar estas funcionalidades, se utiliza un cuaderno de Amazon SageMaker junto con una plantilla de AWS CloudFormation, que proporciona a los usuarios todos los recursos necesarios para replicar el proceso en su entorno. La configuración de OpenSearch para acceder a Amazon Comprehend implica asegurarse de que el sistema tenga los permisos adecuados a través de un rol IAM, que debe estar correctamente mapeado para permitir el uso de la API de detección de idiomas.
Asimismo, se proporciona un pipeline de ingestión que integra la API de Amazon Comprehend, permitiendo añadir automáticamente información sobre el idioma a los documentos en el momento de la indexación. Esta implementación revela cómo OpenSearch puede combinar de forma efectiva modelos de aprendizaje automático de terceros, mejorando tanto la capacidad de búsqueda como la de análisis.
El conector Amazon Bedrock destaca especialmente en la realización de búsquedas semánticas multilingües, utilizando el modelo de embeddings para generar vectores de texto a partir de documentos en diversos idiomas. Este proceso se realiza mediante un flujo de trabajo que incluye la carga de documentos en dataframes y la creación de un índice que almacena tanto los vectores correspondientes como el texto original y su traducción al inglés.
La utilización de estos conectores no solo optimiza la arquitectura del sistema, sino que también reduce la infraestructura requerida, facilitando el mantenimiento y la escalabilidad. Además, se logra una eficiencia en los costos de operación, al eliminar la necesidad de gestionar múltiples puntos finales y simplificar la factura.
Con estas innovaciones, Amazon OpenSearch se posiciona como una herramienta indispensable para quienes buscan no solo almacenar y buscar datos, sino también enriquecer su contenido, lo que permite tomar decisiones fundamentadas en información precisa y contextual.


