

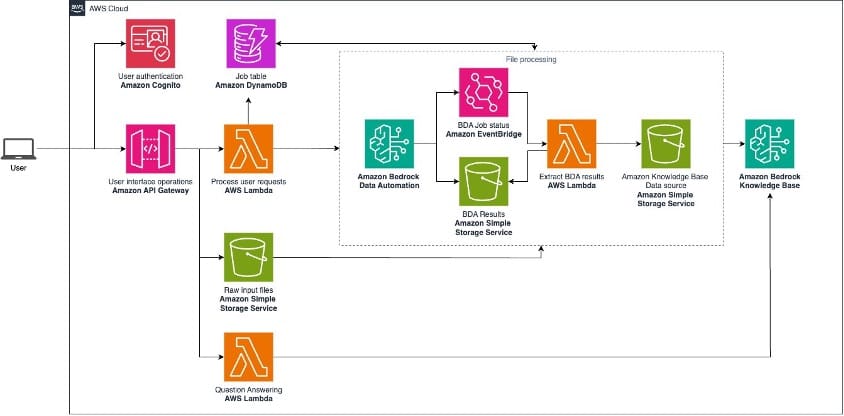
La gestión de grandes volúmenes de datos no estructurados se ha convertido en un desafío significativo para las organizaciones contemporáneas, las cuales enfrentan la necesidad de manejar diversos formatos como documentos, imágenes y archivos de audio y video. Este entorno complejo no solo puede ralentizar los tiempos de procesamiento, sino que también puede incrementar los costos de almacenamiento. Tradicionalmente, la extracción de información relevante de estos datos requería procesos complicados y un esfuerzo de desarrollo considerable, además de una revisión manual que aumenta el riesgo de errores.
Sin embargo, la llegada de tecnologías de inteligencia artificial generativa, como las que ofrece Amazon, está transformando este panorama. La automatización de datos a través de herramientas como Amazon Bedrock permite a las organizaciones procesar y analizar grandes volúmenes de contenido de manera eficiente, reduciendo el esfuerzo manual y mejorando tanto la velocidad como la precisión en la obtención de información.
Con Amazon Bedrock Data Automation y Amazon Bedrock Knowledge Bases, las empresas pueden desarrollar aplicaciones avanzadas que integran diferentes tipos de contenido. Estas soluciones proporcionan flujos de trabajo automatizados que permiten procesar archivos a gran escala de manera eficiente, además de ofrecer un repositorio unificado capaz de comprender consultas en lenguaje natural. Esto facilita la organización y recuperación de información de datos no estructurados, revolucionando la forma en que se gestionan y utilizan.
En diversos sectores se pueden observar casos prácticos de estas herramientas. Por ejemplo, en el sector salud, la automatización permite extraer y estructurar información de registros médicos extensos, facilitando consultas específicas. En el ámbito financiero, instituciones pueden procesar miles de documentos diariamente, permitiendo a analistas realizar preguntas sobre riesgos asociados a informes financieros.
En el ámbito legal, las firmas pueden gestionar grandes archivos relacionados con casos judiciales, mientras que las empresas de medios pueden emplear esta tecnología para mejorar la efectividad de la publicidad contextual. La combinación de un sistema estructurado y una interfaz de preguntas y respuestas basada en generación aumentada de recuperación (RAG) potencia aún más estas capacidades, permitiendo a los usuarios interactuar con su contenido a través de consultas en lenguaje natural.
Este enfoque integral, que une la potencia de la inteligencia artificial generativa con una arquitectura robusta y escalable, representa un avance considerable en el procesamiento y análisis de contenido multimodal. Al integrar estas tecnologías, las organizaciones tienen la oportunidad de convertir datos no estructurados en información valiosa, lo que podría optimizar operaciones y mejorar la toma de decisiones.


