
Los asistentes de chat, impulsados por la Generación Aumentada por Recuperación (RAG), están transformando el panorama del soporte al cliente, las consultas internas y la búsqueda empresarial. Esta innovadora tecnología permite ofrecer respuestas rápidas y precisas utilizando datos internos de las empresas, lo que resulta esencial para mejorar la experiencia del usuario. A través de RAG, es posible usar un modelo base que está listo para implementarse y enriquecerlo con información específica de cada organización. Esto garantiza que las respuestas sean relevantes y contextualizadas, eliminando la necesidad de complicados ajustes o reentrenamientos.
La integración del Amazon Elastic Kubernetes Service (EKS) para operar estos asistentes brinda una gran flexibilidad y control total sobre los datos y la infraestructura utilizada. EKS puede adaptarse a diversas cargas de trabajo, siendo una opción costo-efectiva tanto para demandas constantes como fluctuantes. Su compatibilidad con aplicaciones en entornos Kubernetes, ya sean locales o en la nube, facilita su implementación en diferentes plataformas.
Por otro lado, los microservicios NVIDIA NIM simplifican el despliegue de modelos de inteligencia artificial al integrarse con otros servicios de Amazon Web Services (AWS) como Amazon EC2, EKS y SageMaker. Estos microservicios, que se distribuyen en contenedores Docker, eliminan la complejidad de gestionar modelos de IA, automatizando configuraciones técnicas que, de otro modo, requerirían tiempo y especialización en ingeniería.
Además, el operador NVIDIA NIM facilita la gestión de componentes y servicios en Kubernetes, permitiendo que diferentes modelos operen de manera eficiente. Su arquitectura posibilita una gestión coordinada de recursos, lo que contribuye a reducir la latencia de inferencia y a mejorar las capacidades de escalabilidad automática.
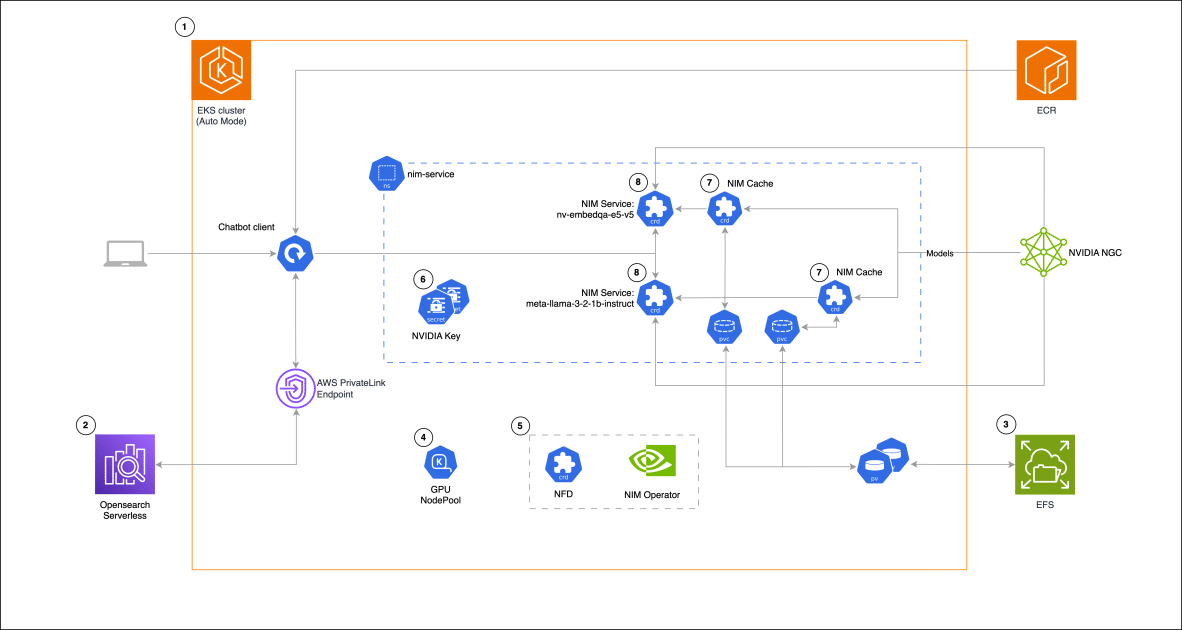
En un caso práctico, se ha desarrollado un asistente de chat RAG utilizando NVIDIA NIM para la inferencia de modelos de lenguaje, combinado con Amazon OpenSearch Serverless para almacenar y consultar vectores de alta dimensión. Esta estructura, habilitada en Kubernetes gracias a EKS, permite un despliegue eficiente de cargas de trabajo de cómputo heterogéneas.
La creación de esta solución implica un proceso que va desde la configuración del clúster EKS y de OpenSearch Serverless hasta el establecimiento de un sistema de archivos EFS y la creación de grupos de nodos con GPU mediante Karpenter. Cada paso está orientado a optimizar el rendimiento y la eficiencia de costos, integrando herramientas que facilitan la gestión de modelos y asegurando que las respuestas sean tanto rápidas como precisas.
Finalmente, la implementación de un cliente de asistente de chat emplea bibliotecas como Gradio y LangChain para ofrecer una interfaz intuitiva. Este sistema permite al asistente recuperar información relevante y generar respuestas contextuales, demostrando que Amazon EKS es una solución efectiva para desplegar aplicaciones de inteligencia artificial, garantizando la fiabilidad y escalabilidad necesarias para enfrentar los retos actuales en el ámbito empresarial.


