

En el ámbito empresarial, las grabaciones de reuniones, entrevistas e interacciones con clientes se han convertido en herramientas fundamentales para conservar información clave. Sin embargo, el proceso manual de transcripción y resumen de estas grabaciones suele ser tedioso y consume mucho tiempo. Con el reciente avance de la inteligencia artificial generativa y el reconocimiento automático de voz, han surgido soluciones automatizadas que hacen este proceso más ágil y eficiente.
En este contexto, el modelo de fundación Open AI Whisper Large V3 Turbo, disponible en el Amazon Bedrock Marketplace, se presenta como una alternativa innovadora. Esta plataforma brinda acceso a más de 140 modelos mediante una API dedicada, lo que permite la producción de transcripciones en casi tiempo real. Las transcripciones generadas pueden ser posteriormente procesadas por Amazon Bedrock para su resumen, eliminando cualquier información sensible que los usuarios deseen proteger.
Amazon Bedrock es un servicio completamente gestionado que ofrece a las organizaciones acceso a modelos de alto rendimiento de reconocidas empresas de inteligencia artificial, como AI21 Labs, Anthropic y Cohere. A través de este servicio, es posible construir aplicaciones de inteligencia artificial generativa con un marcado enfoque en la seguridad y la privacidad de los datos. Además, Amazon Bedrock Guardrails facilita la supresión automática de información sensible, garantizando el cumplimiento normativo en materia de protección de datos.
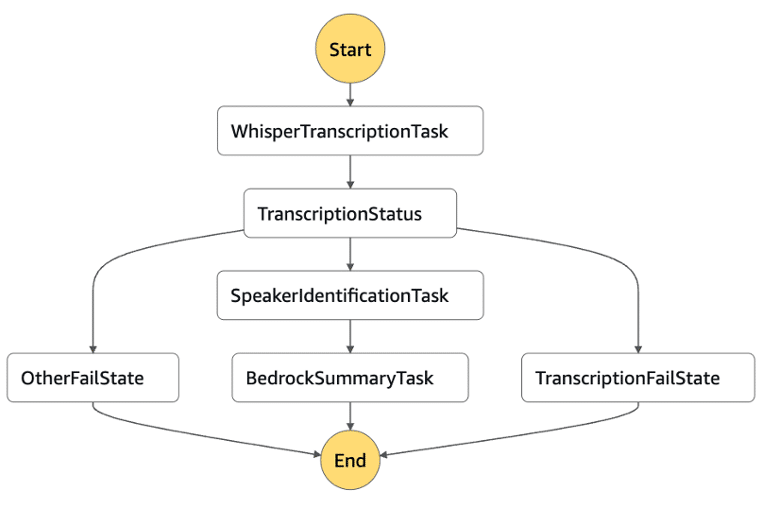
El proceso comienza cuando un usuario carga un archivo a través de una aplicación frontend desarrollada en React, que se aloja en Amazon CloudFront y está respaldada por servicios como Amazon S3 y Amazon API Gateway. Esta acción activa una máquina de estados de Step Functions que organiza los pasos de procesamiento, utilizando modelos de inteligencia artificial y funciones Lambda para asegurar un flujo de datos fluido. Este diseño destaca el potencial de integrar tecnologías sin servidor con inteligencia artificial generativa para optimizar y escalar flujos de trabajo relacionados con el procesamiento de contenido.
El flujo de trabajo se divide en varias fases, que incluyen la transcripción del audio, la identificación de los hablantes y la generación de resúmenes. Un sistema automatizado asegura que cada etapa se complete antes de continuar con la siguiente, incorporando lógica para el manejo de errores y reintentos. Al final del proceso, el usuario recibe un resumen redactado de la grabación, lo que permite mantener la privacidad y cumplir con las normativas vigentes.
Esta solución no solo incrementa la eficiencia en la gestión de la información, sino que también promueve mejores prácticas de seguridad, protegiendo de forma efectiva datos sensibles. Sectores como la salud, las finanzas y los servicios legales, donde la privacidad es primordial, podrán beneficiarse enormemente de la implementación de estas tecnologías avanzadas.


