
La detección de fraudes se ha convertido en un desafío crítico en la industria financiera, donde la innovación tecnológica es esencial para enfrentar patrones fraudulentos cada vez más sofisticados y en constante evolución. En este contexto, el aprendizaje automático ha demostrado ser una herramienta valiosa, aunque los modelos tradicionales enfrentan serias limitaciones relacionadas con la privacidad de los datos y la seguridad de la información.
En 2023, el impacto económico del fraude para las empresas superó los 485.600 millones de dólares, lo que crea una presión considerable sobre las instituciones financieras para adaptarse a nuevas amenazas. Muchos de estos organismos utilizan modelos aislados que, a menudo, llevan al sobreajuste y generan un rendimiento inadecuado en situaciones reales. Las normativas de privacidad de datos, como el GDPR y el CCPA, complican aún más la colaboración entre entidades, restringiendo la posibilidad de compartir información sensible.
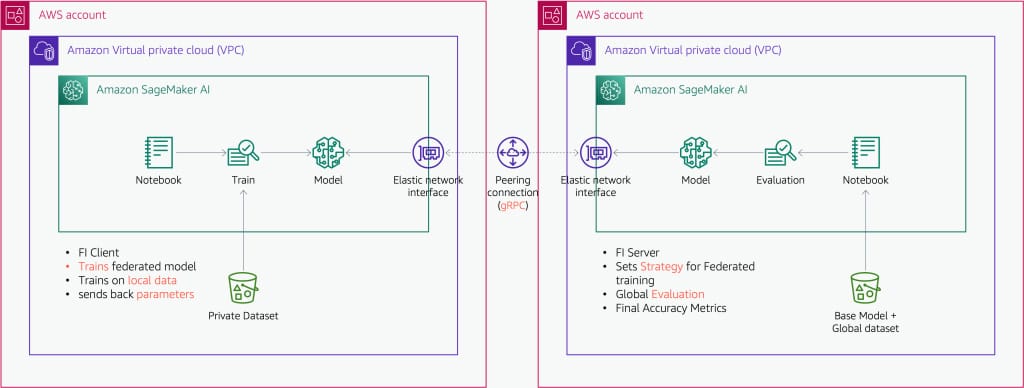
Ante este panorama, el aprendizaje federado ha emergido como una solución efectiva. Este enfoque permite a múltiples organizaciones colaborar en el entrenamiento de modelos conjuntos, preservando la descentralización de los datos. La utilización de tecnologías como Amazon SageMaker AI facilita este proceso, mejorando la precisión en la detección de fraudes y cumpliendo con las regulaciones de privacidad.
El aprendizaje federado no solo se centra en mejorar la efectividad de los modelos, sino que también aborda el preocupante problema del sobreajuste, ofreciendo a las instituciones financieras la capacidad de colaborar sin poner en riesgo la privacidad de la información. Uno de los marcos más prominentes para implementar esta metodología es Flower, que se integra sin problemas con diversas herramientas de machine learning como PyTorch y TensorFlow.
Además, el uso de herramientas como el Synthetic Data Vault permite a las organizaciones generar conjuntos de datos sintéticos que simulan patrones del mundo real, lo que resulta esencial para reforzar la detección de fraudes. Esta estrategia no solo evita la exposición de información sensible, sino que también mejora la capacidad de los modelos para reconocer tácticas fraudulentas en constante metamorfosis. A su vez, el SDV combate el problema del desequilibrio en los datos al incrementar la representación de casos de fraude poco comunes.
La evaluación adecuada de los modelos en un entorno federado es primordial. Las organizaciones deben desarrollar estrategias de conjuntos de datos estructuradas, utilizando diversas combinaciones de datos para garantizar una evaluación justa de los modelos. Esto contribuye a reducir el sesgo y optimizar la justicia en la medición del rendimiento de las herramientas de detección de fraudes.
Los resultados iniciales de estas metodologías han sido esperanzadores, mostrando mejoras significativas en la precisión de la detección de fraudes. Al entrenar con conjuntos de datos variados, los modelos son capaces de identificar un rango más amplio de patrones, lo que a su vez ha reducido los falsos positivos y ha aumentado la eficacia en la detección.
En resumen, el uso del marco Flower en combinación con Amazon SageMaker AI representa un enfoque robusto y respetuoso con la privacidad para la detección de fraudes. Integrando el entrenamiento descentralizado, la generación de datos sintéticos y evaluaciones justas, las instituciones financieras están mejor equipadas para mejorar la precisión en la identificación de fraudes, todo mientras se adhieren a las normativas de privacidad vigentes.


