

El despliegue de soluciones de inteligencia artificial generativa a nivel global enfrenta importantes desafíos, especialmente en la evaluación de la calidad de las respuestas en múltiples idiomas. Muchas organizaciones se ven presionadas a garantizar un rendimiento constante, dado que las evaluaciones humanas demandan recursos significativos, especialmente cuando involucran diversos idiomas. Esto ha llevado a que numerosas empresas se enfrenten a la dificultad de escalar sus procesos de evaluación sin sacrificar la calidad o afectar sus presupuestos.
Ante esta problemática, Amazon Bedrock Evaluations emerge como una solución eficiente. Su capacidad de LLM-as-a-judge permite llevar a cabo evaluaciones de los resultados de inteligencia artificial de manera consistente, superando las barreras lingüísticas. Esta metodología se traduce en una notable reducción del tiempo y recursos normalmente requeridos para realizar evaluaciones multilingües, todo mientras se mantienen altos estándares de calidad.
Aprovechando las funcionalidades de evaluación de Amazon Bedrock, las organizaciones pueden acceder a resultados fiables que cruzan las limitaciones idiomáticas sin necesidad de implementar infraestructuras locales o crear prompts personalizados. A través de pruebas exhaustivas, se han propuesto estrategias prácticas que permiten disminuir tanto el costo como la complejidad de las evaluaciones en varios idiomas.
El proceso de evaluación se simplifica mediante Amazon Bedrock Evaluations, que proporciona métodos tanto automáticos como humanos para medir la calidad de los modelos. Las evaluaciones automáticas permiten a los usuarios optar entre métricas integradas o definir sus propias métricas personalizadas, pudiendo evaluar modelos internos y externos. Las evaluaciones humanas, por su parte, son fundamentales para establecer un punto de referencia que compare las puntuaciones automáticas, ofreciendo el respaldo necesario donde se requiera el juicio de expertos.
En la preparación de conjuntos de datos para la evaluación, se trabajó con divisiones en indonesio de un popular conjunto de datos de evaluación conversacional. Las conversaciones multigeneracionales se transformaron en interacciones de un solo turno para ser evaluadas de manera independiente. Esto generó un conjunto completo de registros evaluativos, analizados utilizando tanto un modelo más robusto como uno más débil.
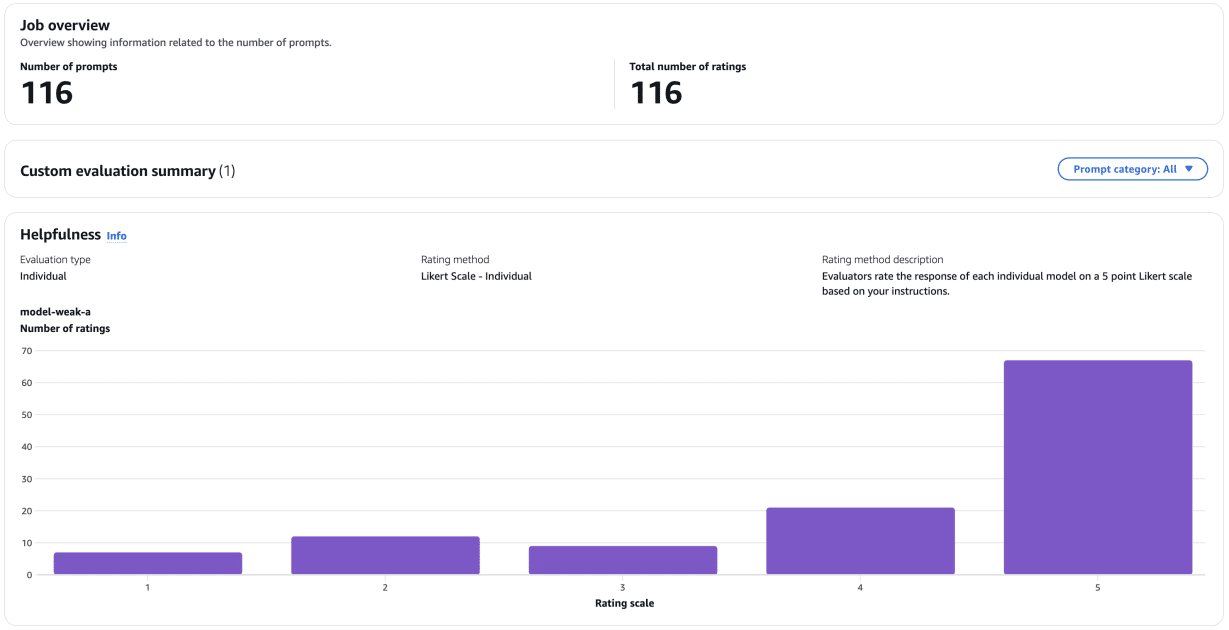
Para establecer un punto de referencia en las evaluaciones humanas, se llevó a cabo una comparación de las puntuaciones de efectividad dadas por evaluadores humanos con las proporcionadas por los LLMs. Los resultados mostraron que en los modelos más fuertes, los jueces LLM coincidieron en gran parte con las calificaciones humanas, mientras que en los modelos más débiles, las puntuaciones se elevaron notablemente en comparación con las de los humanos.
Asimismo, el análisis permitió explorar la correlación entre los puntajes obtenidos, evidenciando un fuerte alineamiento entre los jueces LLM y las evaluaciones humanas en respuestas de modelos más débiles, mientras que el alineamiento en los modelos más fuertes fue más moderado.
La evaluación cruzada entre diferentes idiomas demostró que los resultados se mantenían consistentes, confirmando que, aunque la traducción de prompts es útil, no es estrictamente necesaria para obtener evaluaciones coherentes. Los datos sugieren que el uso de prompts de evaluación en inglés puede ser efectivo incluso para resultados generados en otros idiomas, lo que facilitaría la escalabilidad de las evaluaciones de inteligencia artificial a nivel global.
Esta investigación concluye que los métodos de LLM-as-a-judge son prácticos, ofreciendo una evaluación más rápida y económica, adecuados para implementaciones a gran escala. Sin embargo, la relevancia de las evaluaciones humanas continúa siendo esencial para establecer estándares de referencia y asegurar que las evaluaciones automatizadas se alineen con las expectativas de los usuarios finales.


