
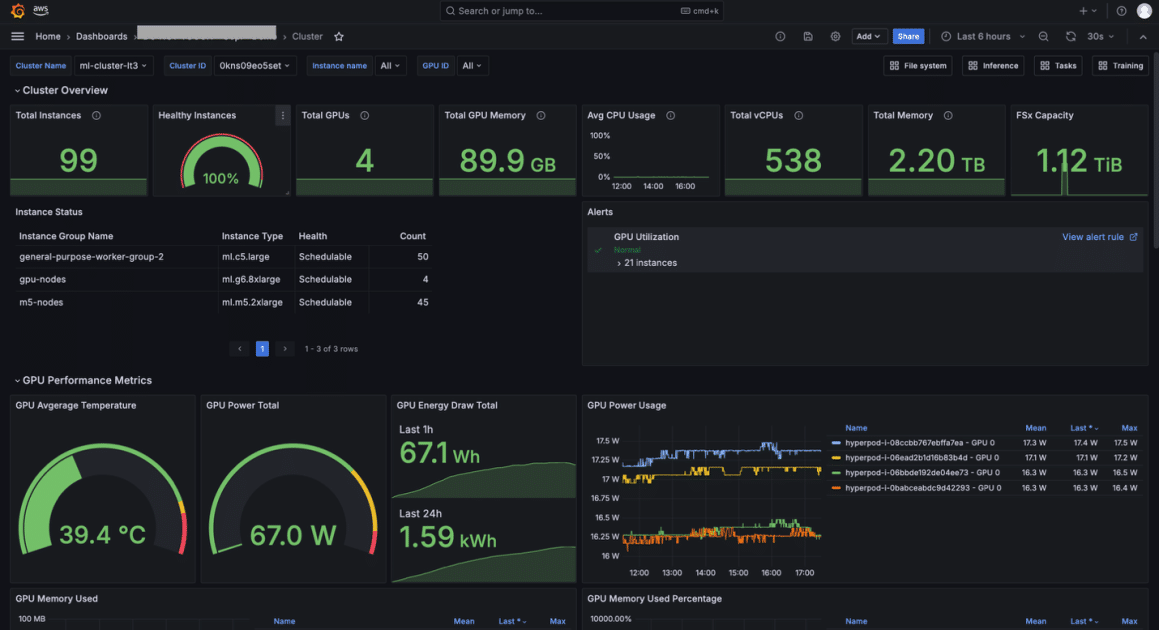
Amazon ha lanzado una nueva funcionalidad en SageMaker HyperPod que promete transformar el desarrollo de modelos de inteligencia artificial. Esta actualización introduce un panel de control integral que proporciona una visión clara de las tareas de desarrollo de modelos fundamentales y de los recursos disponibles en los clústeres, lo que facilita la supervisión y optimización de los procesos.
La nueva solución de observabilidad permite a los usuarios acceder a métricas clave gracias a la integración con Amazon Managed Service for Prometheus y los dashboards diseñados en Amazon Managed Grafana. Estos paneles están enfocados en el desarrollo de modelos fundamentales y ofrecen detalles sobre la salud del hardware, el uso de recursos y el rendimiento a nivel de tareas.
La implementación de esta funcionalidad se realiza rápidamente a través de un complemento de Amazon Elastic Kubernetes Service (EKS), lo que permite consolidar datos de salud y rendimiento de múltiples fuentes, como NVIDIA DCGM y Kubernetes. Esto facilita a los desarrolladores seguir el desempeño de las tareas de modelado en relación con los recursos del clúster, mejorando la identificación de problemas de hardware y la optimización del uso de GPU.
Una de las características más destacadas de esta herramienta es su capacidad para ahorrar tiempo y recursos en el desarrollo de modelos. Los científicos de datos y los ingenieros de aprendizaje automático ahora pueden detectar rápidamente interrupciones en el entrenamiento y la inferencia, así como dificultades en el rendimiento del hardware, acelerando así la comercialización de las innovaciones en inteligencia artificial generativa.
El panel de control de SageMaker HyperPod es altamente configurable, permitiendo la importación de métricas adicionales y la personalización de los diseños en Grafana. Esto hace que la navegación entre métricas y visualizaciones sea intuitiva, ayudando a los usuarios a diagnosticar problemas de manera más eficiente.
Además, los administradores del clúster pueden establecer alertas personalizables que notifican sobre problemas de hardware, lo que permite una respuesta ágil a situaciones críticas. Las alertas se pueden enviar a diversas plataformas, como Amazon SNS o Slack, según las preferencias del equipo.
Esta nueva funcionalidad mejora significativamente la visibilidad sobre el estado y el rendimiento del clúster, optimizando la asignación de recursos al permitir a los administradores identificar patrones de uso ineficientes y ajustar las políticas de priorización.
Con estas herramientas, Amazon reitera su compromiso con la innovación en el ámbito de la inteligencia artificial, ofreciendo a sus usuarios un camino más sencillo y eficiente para llevar sus modelos al mercado.


