
Salesforce y Amazon Web Services (AWS) han anunciado una colaboración destinada a optimizar la implementación de modelos de inteligencia artificial, destacando la importancia de los modelos de lenguaje de gran tamaño (LLMs). El equipo de Model Serving de Salesforce se enfoca en el desarrollo y gestión de servicios que facilitan la integración de algoritmos de aprendizaje automático en aplicaciones críticas, buscando crear una infraestructura robusta para estos fines.
Uno de los grandes desafíos que enfrenta este equipo es lograr un despliegue eficiente de los modelos, asegurando un rendimiento óptimo y una gestión efectiva de costos. Este proceso es especialmente complicado por la amplia variedad en los tamaños y requerimientos de rendimiento de los modelos, que pueden variar desde unos pocos gigabytes hasta alcanzar los 30 GB.
Los especialistas han identificado dos retos clave. Primero, se ha observado que los modelos más grandes suelen ser utilizados de manera ineficiente, lo que resulta en un uso subóptimo de las instancias de múltiples GPUs. Por otro lado, los modelos de tamaño intermedio requieren un procesamiento de bajo tiempo de respuesta, pero esto se traduce en mayores costos debido a la sobreasignación de recursos.
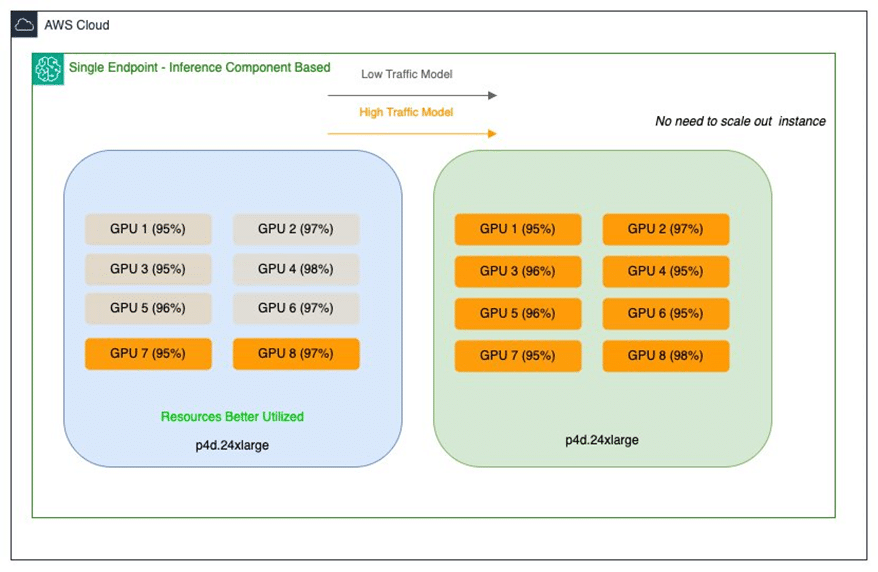
Para abordar estos problemas, Salesforce ha adoptado componentes de inferencia de Amazon SageMaker, que permiten implementar múltiples modelos de base en un único endpoint de SageMaker. Esta estrategia facilita un control más detallado sobre el número de aceleradores y la memoria asignada a cada modelo, mejorando así la utilización de recursos y reduciendo los costos asociados.
La implementación de estos componentes no solo optimiza el uso de GPUs, sino que también permite escalar los modelos de forma independiente según las necesidades específicas de cada aplicación. De esta manera, se abordan problemas inmediatos de implementación y se establece una base flexible que apoyará la evolución de las iniciativas de inteligencia artificial de Salesforce.
Gracias a estas soluciones, la compañía ha logrado reducir significativamente sus costos de infraestructura, alcanzando ahorros de hasta un 80% en los gastos de despliegue. Además, esta optimización beneficia a los modelos más pequeños, permitiéndoles acceder a GPUs de alto rendimiento, lo que mejora su rendimiento y disminuye el tiempo de latencia sin generar costos excesivos.
De cara al futuro, Salesforce tiene planes de aprovechar la capacidad de actualizaciones continuas de estos componentes de inferencia, lo que les permitirá mantener sus modelos actualizados de manera más eficiente, minimizando la carga operativa y fomentando la integración de innovaciones futuras en su plataforma de inteligencia artificial. Con estas acciones, Salesforce se posiciona para seguir creciendo y expandiendo sus ofertas en inteligencia artificial, siempre manteniendo altos estándares en eficiencia y efectividad de costos.


