

La inteligencia artificial generativa ha evolucionado de ser una mera curiosidad a convertirse en un recurso esencial para la innovación en múltiples sectores. Su capacidad para sintetizar documentos legales complejos y desarrollar asistentes virtuales sofisticados ha transformado diversas áreas. Sin embargo, a pesar del progreso en los modelos de lenguaje, la calidad de los datos sigue siendo crucial para generar un impacto significativo en el mundo real.
Un año atrás, la diferenciación en aplicaciones de IA generativa se centraba en quién podía crear o utilizar el modelo más grande. Sin embargo, con el descenso en los costos de entrenamiento de modelos como el DeepSeek-R1 y las mejoras en la relación costo-desempeño, los modelos potentes están volviéndose más accesibles. Este nuevo panorama ha revelado que el verdadero éxito en la IA generativa está cada vez más ligado al acceso a datos de alta calidad.
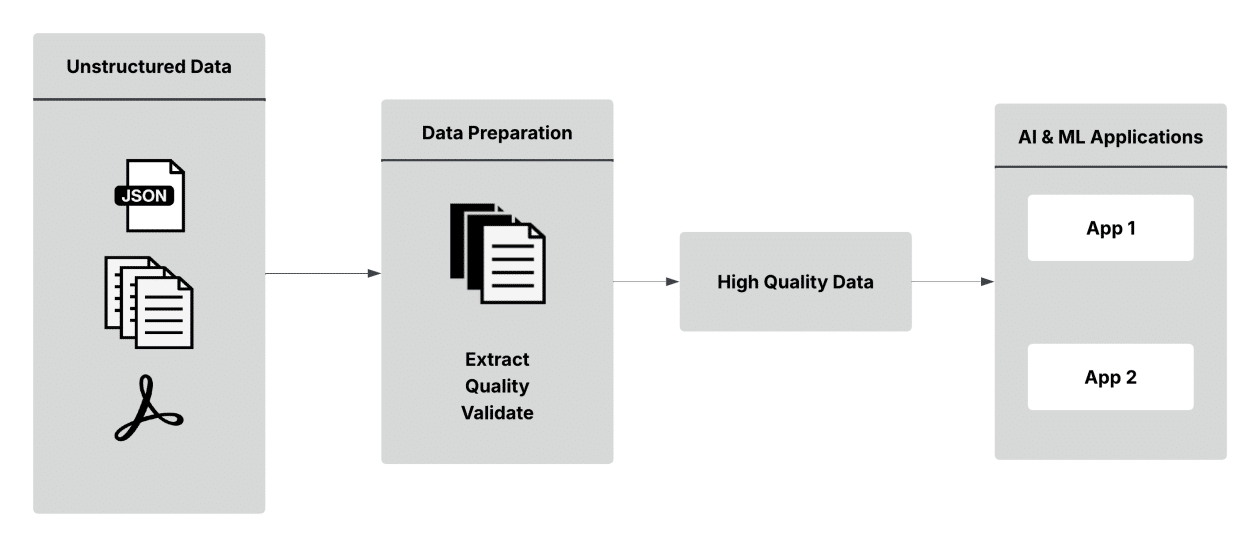
Las organizaciones, que han acumulado grandes volúmenes de datos no estructurados durante décadas, enfrentan el reto de aprovechar esta información. Elementos como transcripciones de llamadas, informes escaneados y registros de redes sociales deben transformarse y cumplir con normativas estrictas, lo que se vuelve vital al trasladar la IA de pruebas a implementaciones reales.
A pesar del aumento en la utilización de IA, muchos proyectos empresariales fracasan debido a la mala calidad de los datos y a la falta de controles adecuados. Se estima que, para 2025, el 30% de los proyectos de IA generativa serán abandonados, dado que incluso las empresas más enfocadas en datos han descuidado el contenido no estructurado, que representa más del 80% de su información disponible.
Para los directores de información y tecnología, gestionar datos no estructurados implica tanto desafíos como oportunidades. La extracción de información y el cumplimiento normativo son tareas frecuentemente manuales, propensas a errores y que consumen muchos recursos, complicando aún más los flujos de trabajo existentes.
En este contexto, adoptar soluciones como Anomalo, en combinación con Amazon Web Services (AWS), puede ser un camino eficaz. Estas herramientas permiten detectar, aislar y resolver problemas de calidad en datos no estructurados de forma rápida y efectiva. Las capacidades automatizadas de ingestión y extracción de metadatos de Anomalo optimizan la identificación de irregularidades y garantizan el cumplimiento normativo, mejorando así la calidad de los datos utilizados en aplicaciones de IA empresarial.
La implementación de este tipo de soluciones podría significar una reducción considerable en la carga operativa, optimización de costos y una aceleración en la obtención de informes y análisis. Integrar la calidad de los datos al núcleo de las aplicaciones de IA permitirá a las empresas aumentar su productividad y mitigar los riesgos asociados con el manejo de información sensible.
En conclusión, el futuro de la IA generativa dependerá en gran medida de la calidad de los datos. Las organizaciones que consigan estructurar y validar eficazmente su información estarán en una posición privilegiada para aprovechar las oportunidades que brinda esta tecnología emergente.


