
En un avance significativo para la inteligencia artificial, OpenAI ha introducido dos nuevos modelos de pesos abiertos, denominados gpt-oss-120b y gpt-oss-20b, que contienen 117 mil millones y 21 mil millones de parámetros, respectivamente. Estos modelos, caracterizados por su arquitectura de Mezcla de Expertos (MoE) y su amplia ventana de contexto de 128K, se han posicionado como líderes en el sector de modelos de código abierto, según los benchmarks de Artificial Analysis. Su rendimiento sobresaliente en tareas de razonamiento y flujos de trabajo dinámicos resalta su potencial.
Los usuarios ahora pueden personalizar y ajustar estos modelos a través de Amazon SageMaker AI, lo que les permite desplegarlos según sus necesidades específicas mediante un servicio gestionado. La flexibilidad que ofrece Amazon SageMaker Inference permite la incorporación de código de inferencia personalizado sin la necesidad de gestionar o mantener clústeres, lo que simplifica aún más el proceso.
A pesar de las capacidades de los grandes modelos de lenguaje (LLMs) para entender y generar contenido, desarrollar aplicaciones que operen de manera autónoma sigue siendo un desafío complejo. Esto se debe a la gestión de flujos de trabajo, la integración de capacidades de llamada a herramientas y la administración del contexto. Las arquitecturas de múltiples agentes ofrecen una solución al descomponer sistemas complejos en componentes especializados, aunque también plantean retos en la coordinación y orquestación de estos agentes.
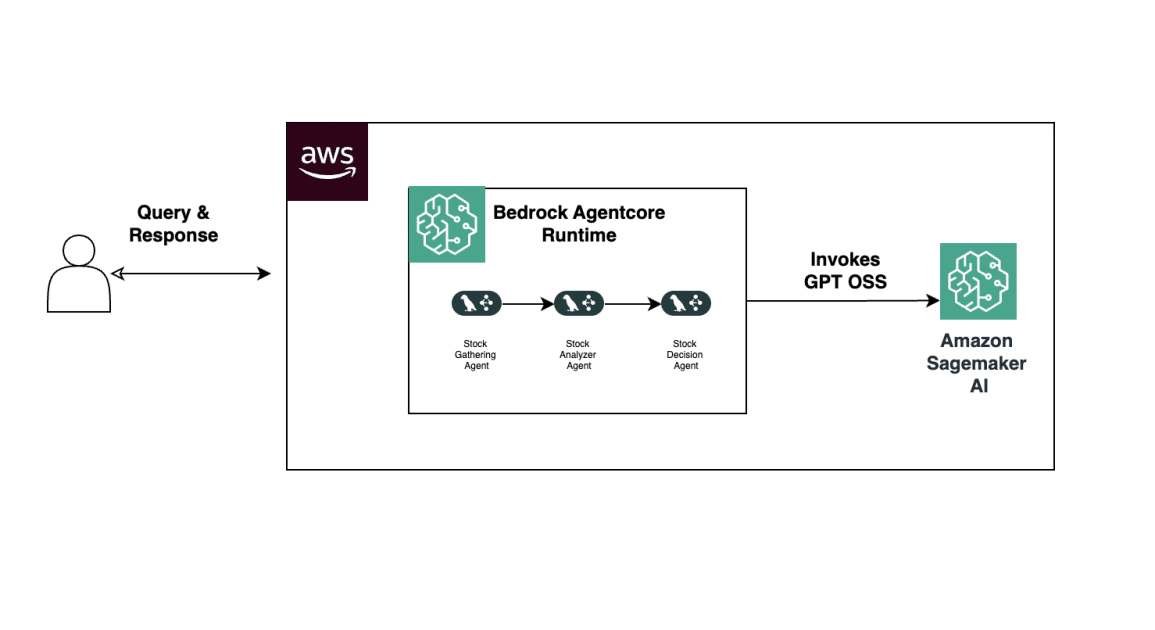
Un reciente artículo explica cómo se puede desplegar el modelo gpt-oss-20b en los endpoints gestionados de SageMaker. Se presenta un ejemplo práctico de un asistente de análisis de acciones utilizando LangGraph, un marco potente centrado en la gestión de estado y flujos coordinados. Posteriormente, los agentes serán implementados en Amazon Bedrock AgentCore, una capa de orquestación que facilita el manejo seguro de agentes de IA a gran escala.
La arquitectura de esta solución incluye un analizador de acciones respaldado por componentes cruciales: el modelo GPT OSS 20B en un endpoint de SageMaker mediante vLLM, LangGraph para la orquestación de múltiples agentes y Amazon Bedrock AgentCore para el despliegue de estos agentes. Los usuarios recibirán orientación sobre cómo configurar sus entornos, manejar permisos y realizar despliegues eficientes, subrayando la utilidad de herramientas como vLLM y Amazon Elastic Container Registry, que facilitan un proceso de hospedaje fluido.
Este enfoque sistematizado no solo busca reducir el tiempo de análisis de acciones, sino también aumentar la productividad de los analistas mediante la automatización de tareas rutinarias, lo que libera recursos valiosos que pueden ser utilizados en cuestiones más estratégicas. También se invita a los interesados a explorar ejemplos de código y a iterar sobre flujos de trabajo de agentes, resaltando así el potencial de los modelos de código abierto en la optimización de procesos.


