
La optimización de aplicaciones de inteligencia artificial generativa está en constante evolución, impulsada por técnicas que buscan personalizar modelos base de manera más eficiente. Entre estas técnicas se encuentran la ingeniería de prompts, la recuperación de documentos, el preentrenamiento continuo y el ajuste fino, los cuales son fundamentales para maximizar el valor y reducir las demandas de recursos durante el entrenamiento de modelos.
Recientemente, se ha presentado un innovador enfoque conocido como Spectrum, que se centra en identificar las capas más informativas de un modelo base. Este enfoque permite llevar a cabo un ajuste fino selectivo, mejorando la eficiencia del entrenamiento al focalizarse en aquellas capas que realmente aportan valor. Además, se han desarrollado métodos que permiten lograr un ajuste más efectivo, como la técnica Quantized LoRA (QLoRA), que combina la adaptación de rango bajo con la cuantización del modelo original. A pesar de que QLoRA ha demostrado ser eficaz en el ahorro de recursos, su implementación se aplica de manera superficial en todo el modelo.
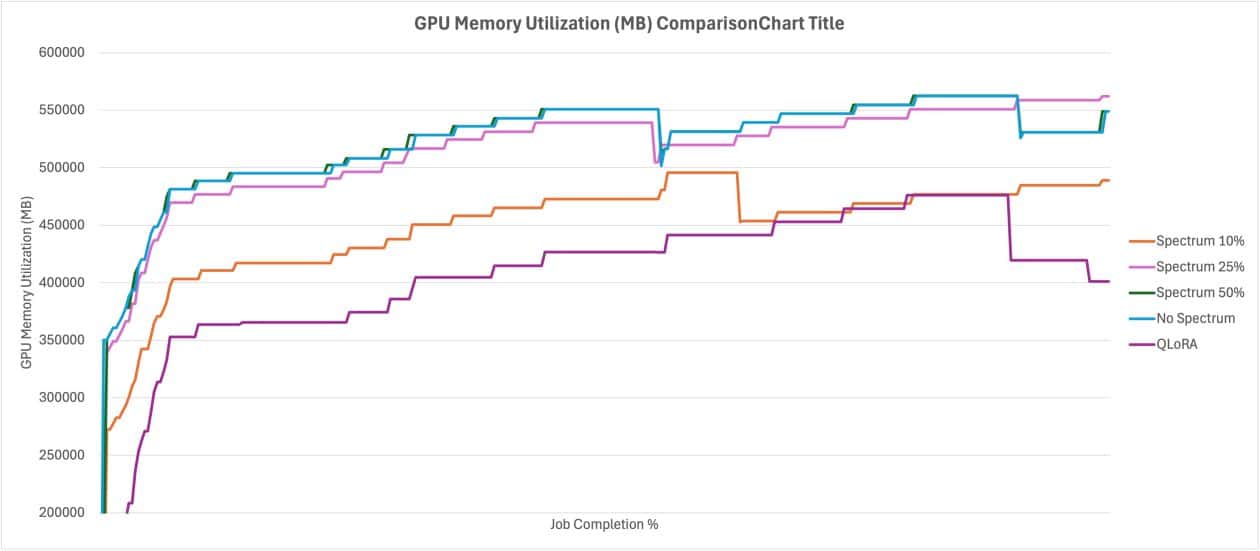
El uso de Spectrum no solo optimiza la utilización de recursos, sino que también acorta los tiempos de entrenamiento, todo sin comprometer la calidad del modelo resultante. Este enfoque se puede aplicar en plataformas como Amazon SageMaker AI, donde se analizan los beneficios y desventajas entre Spectrum y QLoRA. Aunque QLoRA ofrece ventajas en términos de recursos, Spectrum se destaca por su rendimiento superior.
El funcionamiento de Spectrum en el ajuste fino implica una evaluación exhaustiva de las matrices de peso a lo largo de las capas del modelo, calculando la Relación Señal/Ruido (SNR) de cada una. En vez de entrenar todas las capas, Spectrum selecciona un subconjunto en precisión total, basándose en su SNR, mientras que el resto del modelo se congela. Esto permite realizar entrenamientos con diversas precisiones, adaptándose a las capacidades de las GPU más modernas.
Este enfoque se apoya en la Teoría de Matrices Aleatorias y la distribución de Marchenko-Pastur para diferenciar eficazmente entre señal y ruido. A través de un porcentaje configurable, Spectrum identifica las capas más informativas para centrar el ajuste fino en ellas.
Un caso práctico será presentado en el que se muestra la aplicación de Spectrum en el ajuste fino del modelo Qwen3-8B, utilizando Amazon SageMaker. Este proceso abarca varias etapas clave, desde la descarga del modelo y la evaluación de su SNR, hasta la creación de un archivo que determina las capas que deben ser utilizadas durante el entrenamiento.
Para llevar a cabo este proceso, es esencial contar con una cuenta de AWS equipada con los permisos necesarios para crear recursos en SageMaker, así como configurar Amazon SageMaker Studio para ejecutar el código en un entorno Jupyter. Además, será necesario clonar el repositorio de Spectrum y ejecutar scripts de análisis para identificar las capas más influyentes.
El análisis resultará en archivos que detallan el SNR de las capas y especifican aquellas que deben permanecer activas durante el entrenamiento. Esta información permite optimizar el proceso de ajuste fino, garantizando que los recursos se dirijan a las capas más relevantes.
En conclusión, Spectrum representa un avance significativo en la reducción de recursos necesarios para el ajuste fino de modelos base, acortando los tiempos de entrenamiento sin sacrificar la precisión. Esta innovación ofrece nuevas oportunidades en la optimización de modelos de inteligencia artificial, facilitando un enfoque más efectivo en aquellas capas críticas para el aprendizaje.


